原来Scaling Law还能被优化?Meta这招省token又提效
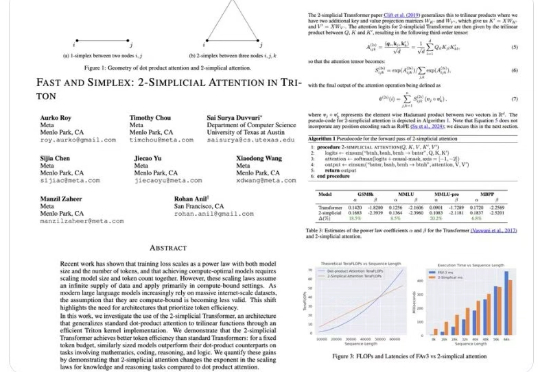
原来Scaling Law还能被优化?Meta这招省token又提效2017 年,一篇《Attention Is All You Need》论文成为 AI 发展的一个重要分水岭,其中提出的 Transformer 依然是现今主流语言模型的基础范式。尤其是在基于 Transformer 的语言模型的 Scaling Law 得到实验验证后,AI 领域的发展更是进入了快车道。
搜索
2017 年,一篇《Attention Is All You Need》论文成为 AI 发展的一个重要分水岭,其中提出的 Transformer 依然是现今主流语言模型的基础范式。尤其是在基于 Transformer 的语言模型的 Scaling Law 得到实验验证后,AI 领域的发展更是进入了快车道。
上周六,我受邀参加了由 InfoQ 举办的 全球人工智能开发与应用大会(AICon),在北京国际会议中心,做了一场题为《AI 时代如何做独立开发》的分享。
现在再讨论 AI 写作,多少有点没劲:prompt 真的越来越像咒语了,越来越像一些神秘不可洞察的玄学技巧。这导致使用 AI 写东西的过程,不管是写什么类型的文字,过程都跟做法似的:赌指令能不能触发出一些好的生成。同时还得用大量的指令,去掉「AI味」。
罗宾汉大撒币,OpenAI狂摇头 OpenAI还没上市,怎么已经有“山寨股票”先行一步了? 当地时间7月2日,OpenAI的官方X(前推特)账号发布了一个义正词严的公告: “这些‘OpenAI 代币’并非 OpenAI 股权。我们没有与 Robinhood 合作,没有参与此事,也不为其背书。任何 OpenAI 股权的转让都需要我们的批准——我们从未批准过任何转让。请谨慎操作。”
不要让AI成为「垃圾制造机」。 谁能想到,一个 AI 生成的视频竟然在 ins 上拿下 2.52 亿次浏览量,仅点赞就达到 325.7 万次。
再聪明的机器也不能代替我们生活 从今年年初开始,美国一些专注于报道 AI 的记者们,陆陆续续接到邮件。这些邮件来自不同的人,内容却如出一辙:都是各种惊天大秘密。
你可能没发觉,AI 在很多地方都已经开始「替你创作」了。你最近听的歌、刷到的直播、点开的短片,背后可能并没有真实的「人」。
Jack Clark 是最关注和熟悉中国在芯片、计算和模型上进展的 AI Lab 领导人之一。他毫不吝啬对中国 AI 进展的认可,将 DeepSeek R1 视作“推理模型大范围扩散”的起点,近期又把 HyperHetero 使用的异构集群叫做通过“超级智能进行持续自我训练”的垫脚石。
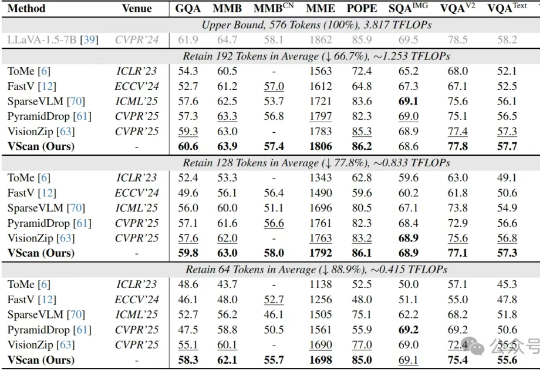
多图像、长视频、细粒度感知正在让大型视觉语言模型(LVLM)变得越来越聪明,但也越来越“吃不消”:视觉Token数量的激增所带来的推理成本暴涨,正逐渐成为多模态智能扩展的最大算力瓶颈。
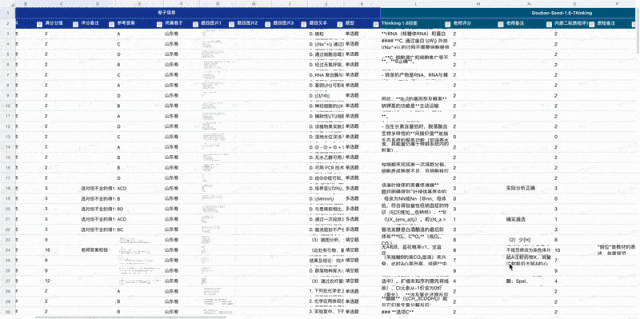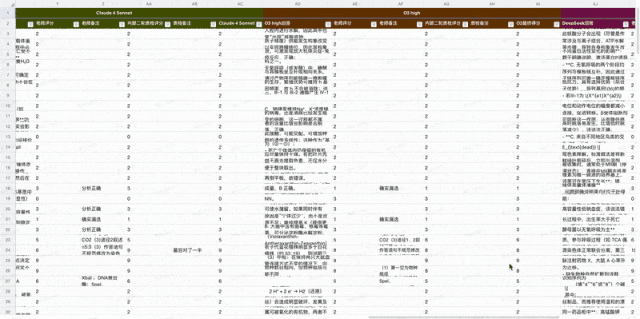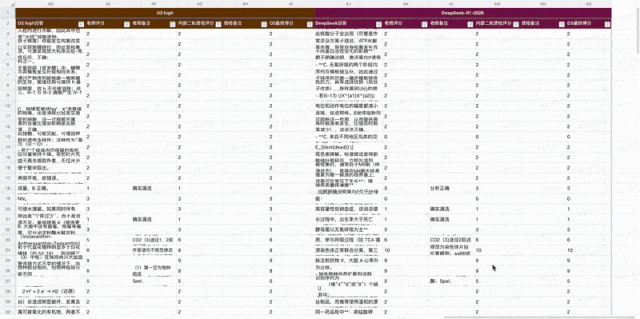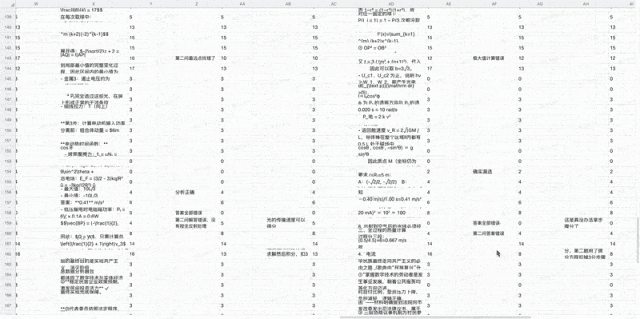
这个AI让打工人「磕头」致谢。 前段时间,我们报道了 5 款大模型参加了今年山东高考的事儿,为了弄清楚各大模型在 9 个科目中的具体表现,我们对着测评明细表挨个儿分析,搞得狼狈又崩溃。要是哪个 AI 能一键分析表格,我当场就能给它磕一个。